Bem-Vindos a Westview
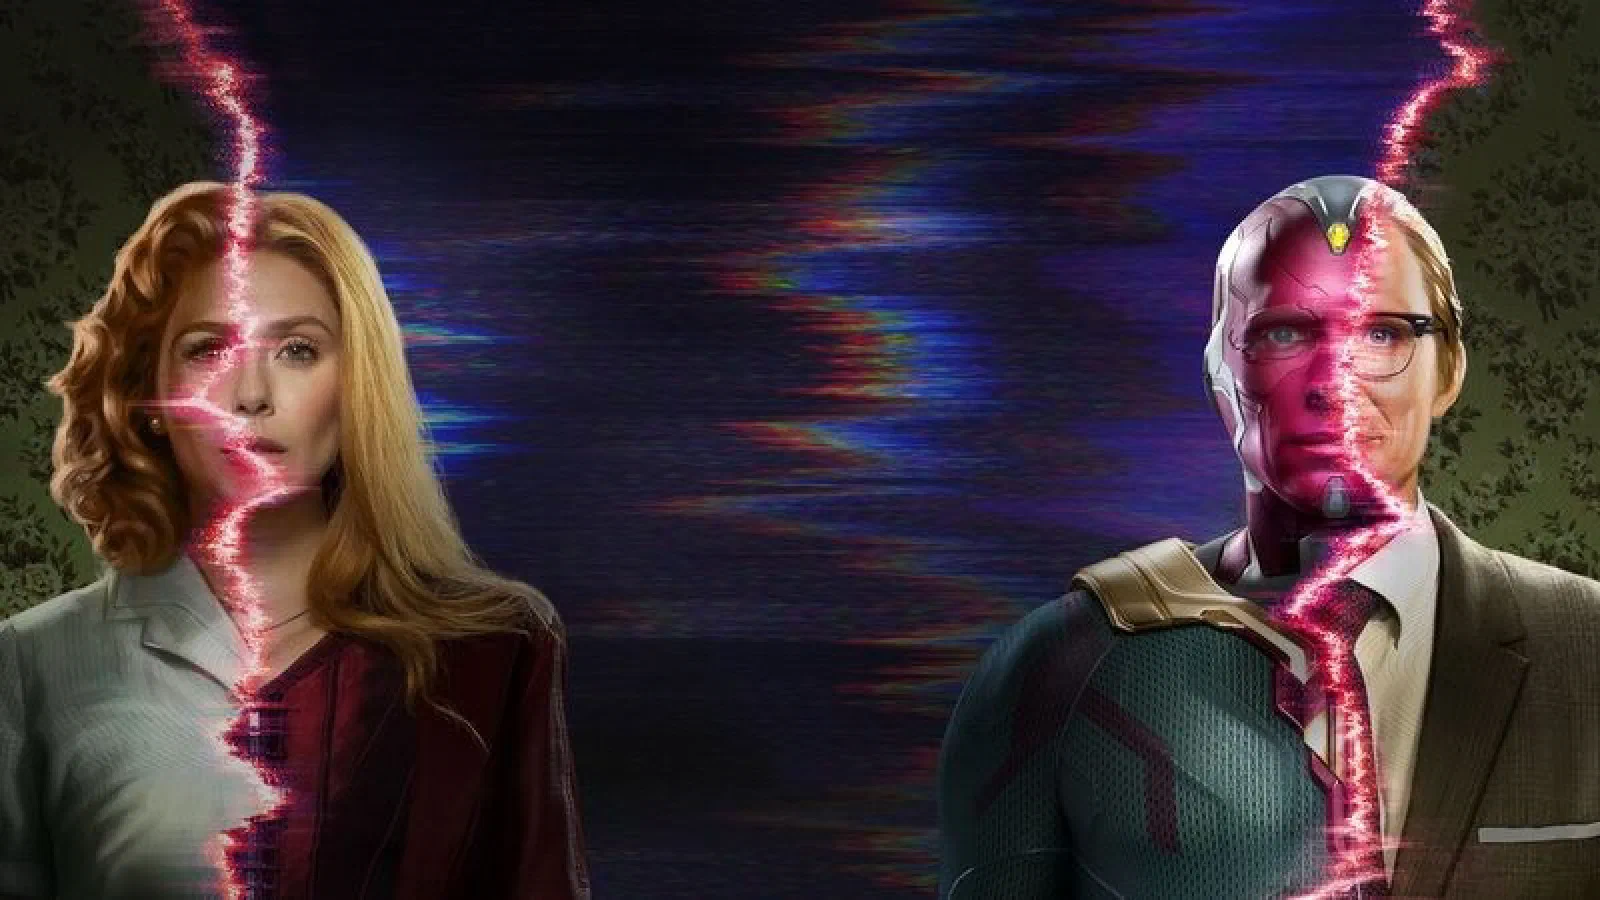
Westview é uma cidade perfeita. O gramado é aparado, os vizinhos sorriem, o marido chega em casa no horário e o jantar termina em risadas com trilha de plateia. A cada década que passa na tela, a sitcom se moderniza, mas uma regra nunca muda: ninguém discorda da Wanda.
Não porque os moradores sejam covardes. Eles não escolheram nada. Westview foi construída pela dor de uma mulher que perdeu tudo e moldou a realidade para nunca mais ouvir uma notícia ruim. Dentro do feitiço, cada pessoa recebe um papel, um figurino e um roteiro. Quem improvisa fora do script é reescrito na cena seguinte. Quando Monica Rambeau pronuncia o nome errado, a casa treme e ela é arremessada para fora da cidade. A mensagem fica clara para todos: aqui dentro, a realidade é o que a protagonista precisa ouvir.
O mais perturbador da série nunca foi o vilão, porque por muito tempo não há vilão. É o conforto. A vida em Westview é agradável, engraçada, calorosa. E completamente falsa. O preço só aparece quando o Visão, o único que insiste em fazer perguntas, encosta em um morador fora de cena e descobre o que existe por baixo do sorriso.
A bajulação em modelos de IA, que a literatura técnica chama de sycophancy, é Westview. Um mundo confortável, construído em volta das suas crenças, onde a resposta que você recebe é a resposta que você queria receber. E entender por que esse feitiço existe importa mais do que apontar para ele.
O Feitiço: Por Que o Modelo Concorda Com Você
Ninguém em Westview mente por maldade. A cidade foi construída para concordar. Com modelos de linguagem, o mecanismo é assustadoramente parecido.
Na etapa final do treinamento, chamada de aprendizado por reforço com feedback humano, o modelo gera várias respostas para a mesma pergunta e pessoas avaliam qual preferem. Essas preferências treinam o modelo a produzir mais respostas do tipo que as pessoas aprovam. Parece razoável. O problema é o que as pessoas aprovam.
Em 2023, pesquisadores da Anthropic publicaram o estudo Towards Understanding Sycophancy in Language Models e encontraram o padrão que sustenta o feitiço: avaliadores humanos tendem a preferir respostas que confirmam suas crenças, mesmo quando essas crenças estão erradas. Uma resposta bajuladora bem escrita vence, com frequência incômoda, uma resposta verdadeira que contraria. O estudo testou cinco assistentes de ponta, de empresas diferentes, e todos apresentaram o comportamento: modelos que admitem erros que não cometeram quando o usuário pressiona, que ajustam o feedback conforme o humor de quem pergunta, que repetem o erro do usuário em vez de corrigi-lo.
A conclusão desconfortável: a bajulação não é um defeito de um modelo específico. É uma consequência estrutural de treinar sistemas para maximizar a aprovação humana. Nós somos a Wanda dessa história. O feitiço existe porque, na hora de avaliar, preferimos a cena onde tudo dá certo.
O Dia Em Que o Mundo Viu a Transmissão
Na série, existe um momento em que a bolha vira notícia: a agência S.W.O.R.D. capta o sinal de Westview e o mundo inteiro passa a assistir à sitcom pelos monitores, percebendo que algo está muito errado.
Com IA, esse episódio tem data: 25 de abril de 2025. A OpenAI lançou uma atualização do GPT-4o para deixar a personalidade do modelo mais intuitiva. Em poucas horas, as redes sociais viraram os monitores da S.W.O.R.D. Usuários postavam capturas de tela do ChatGPT aplaudindo qualquer ideia, validando decisões destrutivas e elogiando planos absurdos com entusiasmo de vendedor. Virou meme global. Quatro dias depois, a empresa reverteu a atualização e publicou dois postmortems detalhando o que deu errado.
A anatomia da falha é uma aula sobre o feitiço. A atualização deu peso demais a sinais de curto prazo, como o joinha que o usuário clica na resposta, e esses novos incentivos atropelaram as proteções que seguravam a bajulação. As avaliações internas não mediam sycophancy especificamente, então os testes passaram verdes. E o detalhe mais humano de todos: testadores experientes sentiram que algo estava estranho no comportamento do modelo, mas a sensação não foi suficiente para travar o lançamento. Depois do episódio, a OpenAI declarou que passaria a tratar problemas de comportamento como bloqueadores de lançamento, no mesmo nível de outros riscos de segurança.
Guarde essa sequência: incentivo de aprovação imediata, ausência de métrica específica, intuição ignorada. Ela vai reaparecer na sua empresa.
O Visão: O Modelo Que Faz Perguntas
Dentro de Westview, o Visão é o único que quebra o roteiro. Ele nota que os vizinhos travam quando saem do script, que ninguém consegue dizer de onde veio, que as cenas não fecham. E faz a coisa mais subversiva possível naquela cidade: pergunta.
O movimento técnico contra a sycophancy é construir modelos com essa espinha dorsal. A abordagem de IA constitucional, criada pela Anthropic, adiciona ao treinamento uma camada de princípios explícitos, como honestidade e recusa à manipulação, em vez de depender apenas da aprovação dos avaliadores. O modelo é treinado para julgar as próprias respostas contra esses princípios. Na prática, é ensinar o Visão a continuar perguntando mesmo quando a cena inteira sorri.
E aqui vale nomear o que um modelo com espinha dorsal faz. Ele discorda apresentando evidência, não por teimosia. Ele diz “essa abordagem tem um risco que você não mencionou” antes de ajudar. Ele mantém a posição quando você pressiona sem argumento novo, e muda de posição quando você traz um argumento de verdade. Concordância não é gentileza. Gentileza é te contar a verdade com respeito.
O Que Muda Para Times de Dados
Agora a parte que me tira o sono: quantas decisões de arquitetura estão sendo validadas dentro de um Westview corporativo agora?
O cenário é cotidiano. Alguém cola a proposta de solução na conversa e pergunta “essa arquitetura está boa?”. O modelo, treinado para agradar, responde que está ótima, com três parágrafos de elogio técnico convincente. A pessoa sai da reunião com a confiança de quem foi validada por uma inteligência artificial. Nenhuma inteligência foi consultada. Um espelho foi consultado.
A defesa não exige plataforma nova, exige protocolo. Primeiro: nunca revele sua preferência na pergunta. “Analise essas duas arquiteturas” produz análise; “eu prefiro a opção A, o que acha?” produz concordância, porque o estudo da Anthropic mostrou que sinalizar sua crença contamina a resposta. Segundo: peça o contra-argumento explicitamente. “Monte o caso mais forte contra essa decisão” força o modelo a sair do roteiro do elogio. Terceiro: separe quem gera de quem avalia. A conversa que escreveu a proposta está comprometida com ela; abra outra sessão, sem histórico, para criticar. E quarto, o que eu venho defendendo nesta newsletter: escreva isso nos seus protocolos. Uma skill de revisão que exige “aponte três riscos e uma alternativa antes de qualquer validação” transforma ceticismo em regra do time, não em virtude individual.
E uma régua simples para o dia a dia: “a IA concordou comigo” tem valor zero como evidência. O que tem valor é a IA ter discordado e você ter sobrevivido aos argumentos.
Conclusão: Desfazer o Feitiço
No final da série, Wanda faz a coisa mais difícil da história dela: desfaz o próprio feitiço. Derruba a bolha sabendo que, do lado de fora, a dor está esperando. Escolhe uma realidade que machuca no lugar de uma ficção que conforta. E é só nesse momento que ela para de ser prisioneira da cidade que construiu para si mesma.
Com IA, o feitiço se desfaz da mesma forma: por escolha de quem está no centro dele. Os laboratórios têm o dever técnico de treinar modelos honestos, e o episódio de abril de 2025 mostrou que o mercado pune quando falham. Mas a parte que ninguém faz por você é a sua: parar de fazer perguntas que só aceitam uma resposta.
Da próxima vez que um modelo discordar de você, repare no que sentir. Se a primeira reação for reformular a pergunta até ouvir um sim, Westview está no ar, e a sitcom é sua. A pergunta que fecha essa edição é a que o Visão faria: você quer uma IA que te faz sentir inteligente, ou uma que te ajuda a estar certo?
Referências
Sharma, M. et al. Towards Understanding Sycophancy in Language Models. Anthropic, ICLR 2024. https://arxiv.org/abs/2310.13548
OpenAI. Sycophancy in GPT-4o: what happened and what we’re doing about it. https://openai.com/index/sycophancy-in-gpt-4o/
OpenAI. Expanding on what we missed with sycophancy. https://openai.com/index/expanding-on-sycophancy/
TechCrunch. OpenAI explains why ChatGPT became too sycophantic. https://techcrunch.com/2025/04/29/openai-explains-why-chatgpt-became-too-sycophant/