Hoje o tema é Data Factory + DevOps, vamos conferir ?
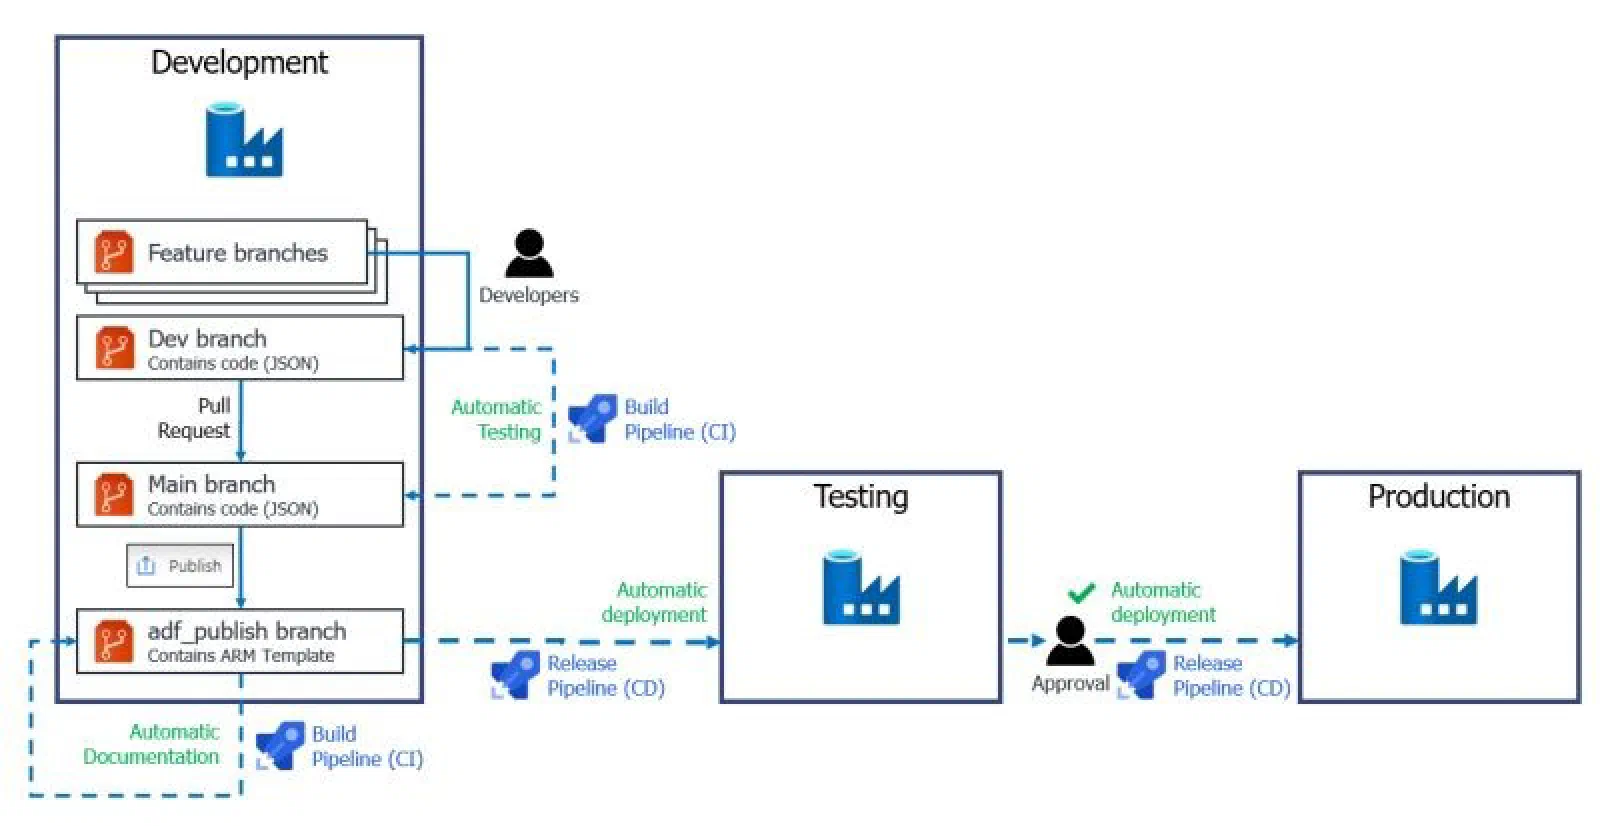
CI é a prática de testar automaticamente cada alteração de código, enquanto o CD implementa essas alterações nos sistemas de staging ou produção. No Azure Data Factory, a CI/CD envolve a movimentação de pipelines entre diferentes ambientes.
Veja como funciona:
1️⃣ Os desenvolvedores criam um branch de feature para fazer alterações e depurar a execução de pipelines.
2️⃣ As alterações são revisadas por meio de pull requests e mescladas no branch principal.
3️⃣ As alterações são então publicadas no factory de desenvolvimento.
4️⃣ Quando estiverem prontas, as alterações são implantadas em um factory de teste ou UAT usando o Azure Pipelines.
5️⃣ Após a verificação, as alterações podem ser implantadas no factory de produção.
Melhores práticas para CI/CD no Azure Data Factory:
✅ Configure a integração com o Git apenas para o factory de desenvolvimento.
✅ Use scripts de pré e pós-implantação para tarefas como parar/reiniciar acionadores.
✅ Considere o uso de um factory compartilhado para runtimes de integração em todas as etapas.
✅ Gerencie com cuidado a implantação de pontos de extremidade privados para evitar conflitos.
✅ Separe vaults de chaves para diferentes ambientes e mantenha nomes de segredos consistentes.
✅ Evite espaços nos nomes de recursos; use ‘_’ ou ‘-’ em vez disso.
✅ Tenha cautela ao alterar o repositório para evitar erros.
✅ Utilize o controle de exposição e flags de recursos para gerenciar a lógica com base no ambiente.
❌ Lembre-se de que a publicação seletiva de recursos não é recomendada devido a dependências.
Um Abraço e até o próximo artigo !