Olá a todos, essa semana vamos apresentar algumas melhores práticas para um pipeline de ingestão de dados:
💡 Crie pipelines dinâmicos com Padrões de Ingestão Impulsionados por Metadados:
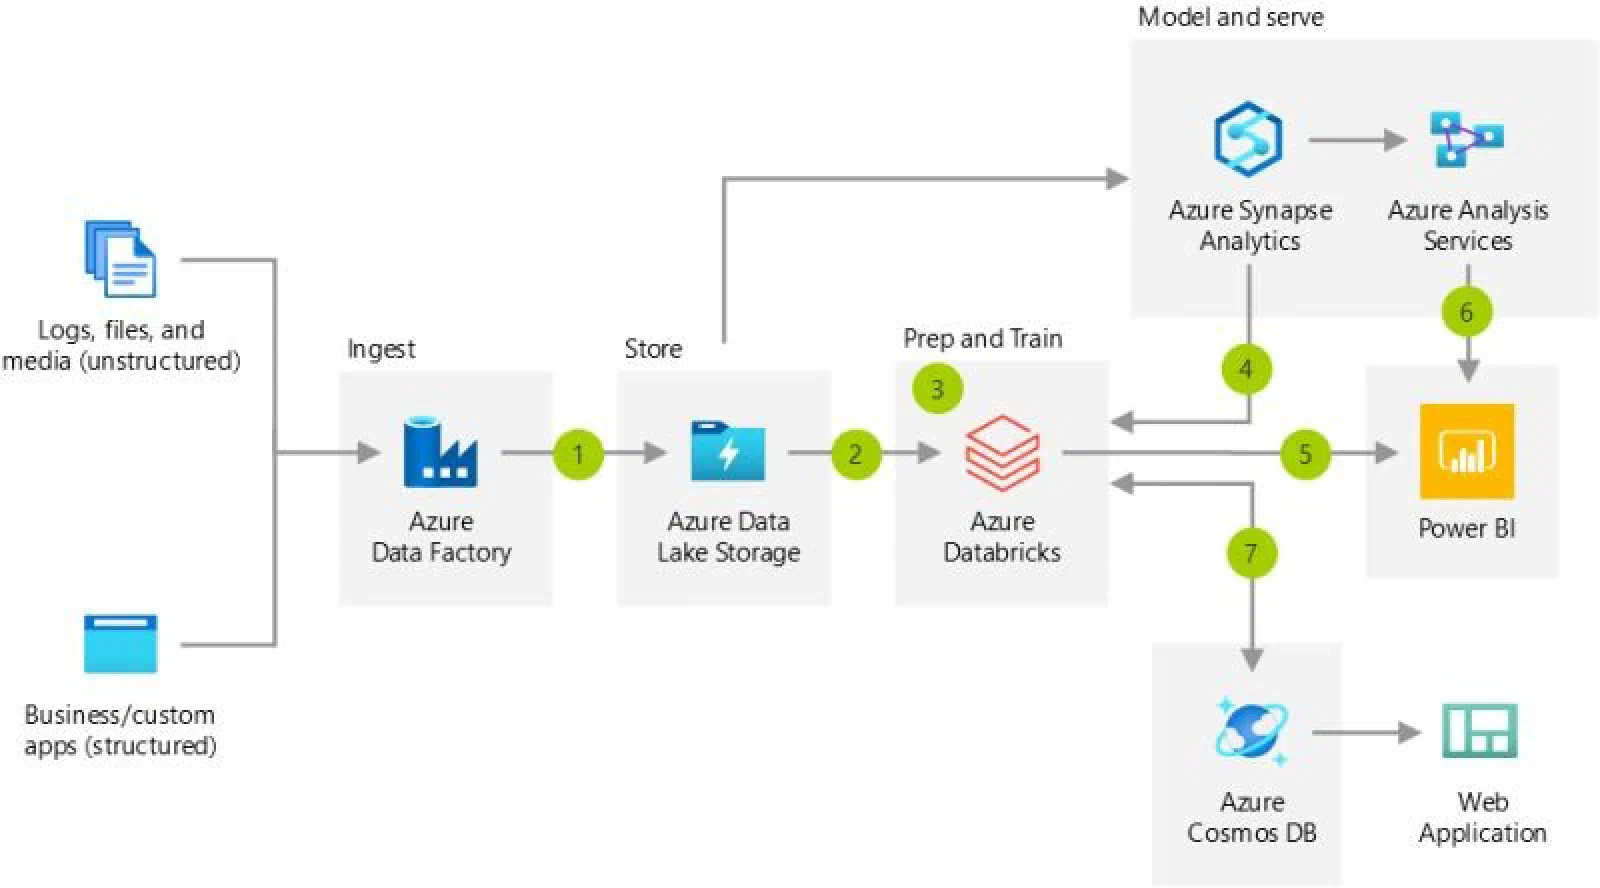
✅ O ADF gera código usando metadados para ler fontes de dados e tabelas/diretórios para o lakehouse.
✅ Agilize a incorporação de novas fontes de dados adicionando metadados ao framework da solução.
💡 Ingestão de dados usando Auto Loader ou diretamente no Delta Lake:
✅ O Auto Loader processa eficientemente novos arquivos de dados no ADLS Gen2, com inferência de esquema e evolução de alterações nos dados.
✅ O conector Delta Lake do ADF aterrissa automaticamente os dados no ADLS Gen2 no formato de arquivo Delta Lake.
💡 Execute facilmente Jobs do Azure Databricks:
✅ Use as atividades web do ADF e a API de Jobs do Azure Databricks para executar jobs do Databricks e pipelines do Delta Live Tables.
✅ Beneficie-se das últimas funcionalidades dos jobs, como reutilização de clusters, passagem de parâmetros e reparo e rerun.
💡 Aproveite os Pools + Clusters de Jobs:
✅ O ADF pode usar pools do Azure Databricks para criar clusters de jobs para execuções de atividades de notebook.
✅ Desfrute de isolamento de carga de trabalho, preços reduzidos, auto-terminação, tolerância a falhas e criação mais rápida de clusters de jobs.
💡 Garanta autenticação segura com a Identidade Gerenciada do ADF:
✅ Autentique o ADF no Azure Databricks usando autenticação de identidade gerenciada.
✅ Fornece uma técnica de autenticação mais segura e elimina a necessidade de gerenciar tokens de acesso pessoais.
Espero que tenha gostado da leitura !